
 English
光给细胞"贴邮编":MOLseq 无偏空间单细胞组学
核心结论:空间组学长期被一道选择题困住——要么用成像法拿到亚细胞级分辨率,却要预先挑好要测的基因;要么用测序法做全基因组无偏扫描,却只能得到粗糙的二维位置。哈佛大学 Zhuang 团队(Scientific Reports 2026)提出的 MOLseq 想把两家的好处合在一起:先用图案化紫外光在细胞原位把空间位置"写"成一段 DNA 条码,再裂解、建库、上机测序,让每一条测到的 mRNA 都能被定位回它原来的坐标。原理验证显示,每轮光控连接效率约 90%,5 轮可生成约 750 个唯一条码,单细胞水平脱靶率低至 1–2.5%,人鼠混合样本中测序定位准确率 >92%。相当于给每个细胞贴了一张由光打印的"空间邮编"。 > 一句话记住它:MOLseq = 光控连接写条码 + 高通量测序读位置。它把"成像法的高空间精度"和"测序法的无偏通量"塞进了同一个流程。
一、空间组学的两难:要通量,还是要分辨率?
过去十几年,空间组学彻底改变了我们研究组织与疾病的方式。但现有方法本质上分两大门派,各有死穴。
- 成像派(如原位杂交、原位测序):直接在组织里把分子"看"出来,分辨率能做到亚细胞级,甚至能区分同一条细胞里的不同角落。代价是——你必须提前选定要探测的基因或基因组位点,通量受限于你能同时染的探针数。想知道什么,得先猜到什么。 - 测序派(如空间转录组 10x Visium、Slide-seq):先把组织里的分子带上位置相关的条码,再统一送去测序,做到全基因组无偏扫描。代价是空间分辨率偏低,通常是几十微米量级的二维网格,远远谈不上单细胞,更别说亚细胞。
能不能既要、又要?光控空间条码是近年的一条主线——用光照把"位置信息"编码进分子。代表性的 Light-seq、ZipSeq 已经证明这条路走得通,但它们大多只在少数几个大区域(例如 Light-seq 仅演示了 3 个条码)上做文章,多重性(能同时区分多少空间单元)很有限。
MOLseq 换了一套光控连接化学,思路是用多轮迭代、每次往 cDNA 上追加一小段寡核苷酸作为"字母",条码的多样性随轮数指数增长(mⁿ:m 种字母、n 轮 → mⁿ 个唯一定位),并且天然带纠错能力。
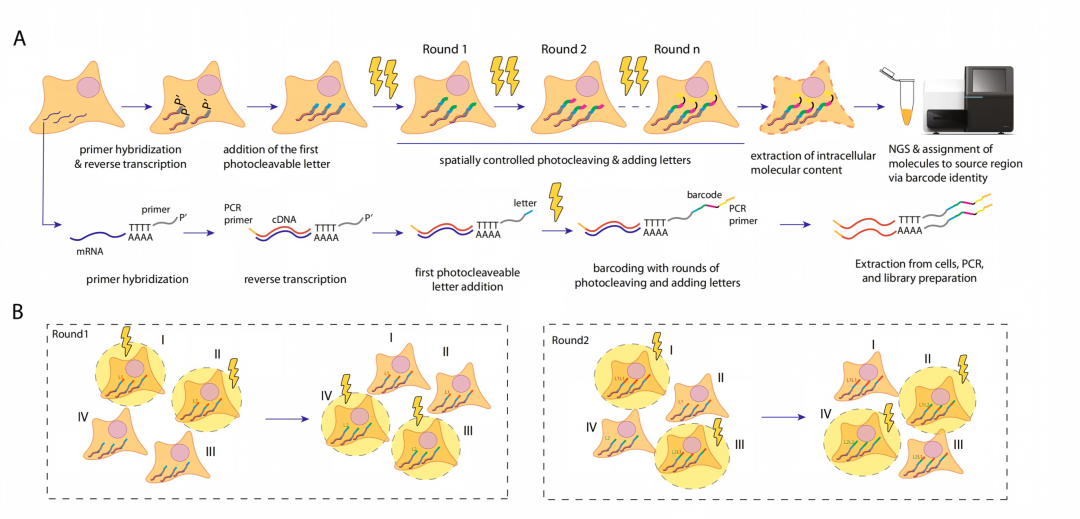
▲ 图1|MOLseq 工作流程与多重光控条码原理。A:在单细胞内,先用 poly-T 引物杂交 mRNA,原位逆转录生成 cDNA 并在 3'端引入 PCR 引物;随后用图案化紫外光在 cDNA 5'端逐轮"写"入字母构成的空间条码;细胞裂解后提取、PCR 扩增、建库测序,条码即可把每条识别到的分子指回其空间位置,形成空间分辨的组学图谱。B:两路图案光照示意——每轮光照给条码添加一位字母(L1 或 L2),多轮之后条码多样性随轮数指数上升,带来可扩展性与多重性。
二、MOLseq 怎么"写邮编":光控连接化学
整套流程的硬件核心,是一个叫 DMD(数字微镜器件) 的装置,它把紫外光精确地投成任意图案,照到哪些细胞,哪些细胞就被"盖章"。但真正巧妙的是化学:每一轮添加的新字母 DNA 上带有一段光可裂解间隔基(photocleavable spacer, PC)。
- 第一步,把带 PC 的新字母和一段"夹板(splint)"引到 cDNA 末端,发生连接反应,条码变长一位; - 接着用 UV 照射把 PC 切断,暴露出新的 5' 磷酸基团; - 这个磷酸就是下一轮连接的"接口",于是又能接上下一个字母。
也就是说,照一次光 = 加一个字母,不照就不加。位置信息就这样被写进了分子的序列里。
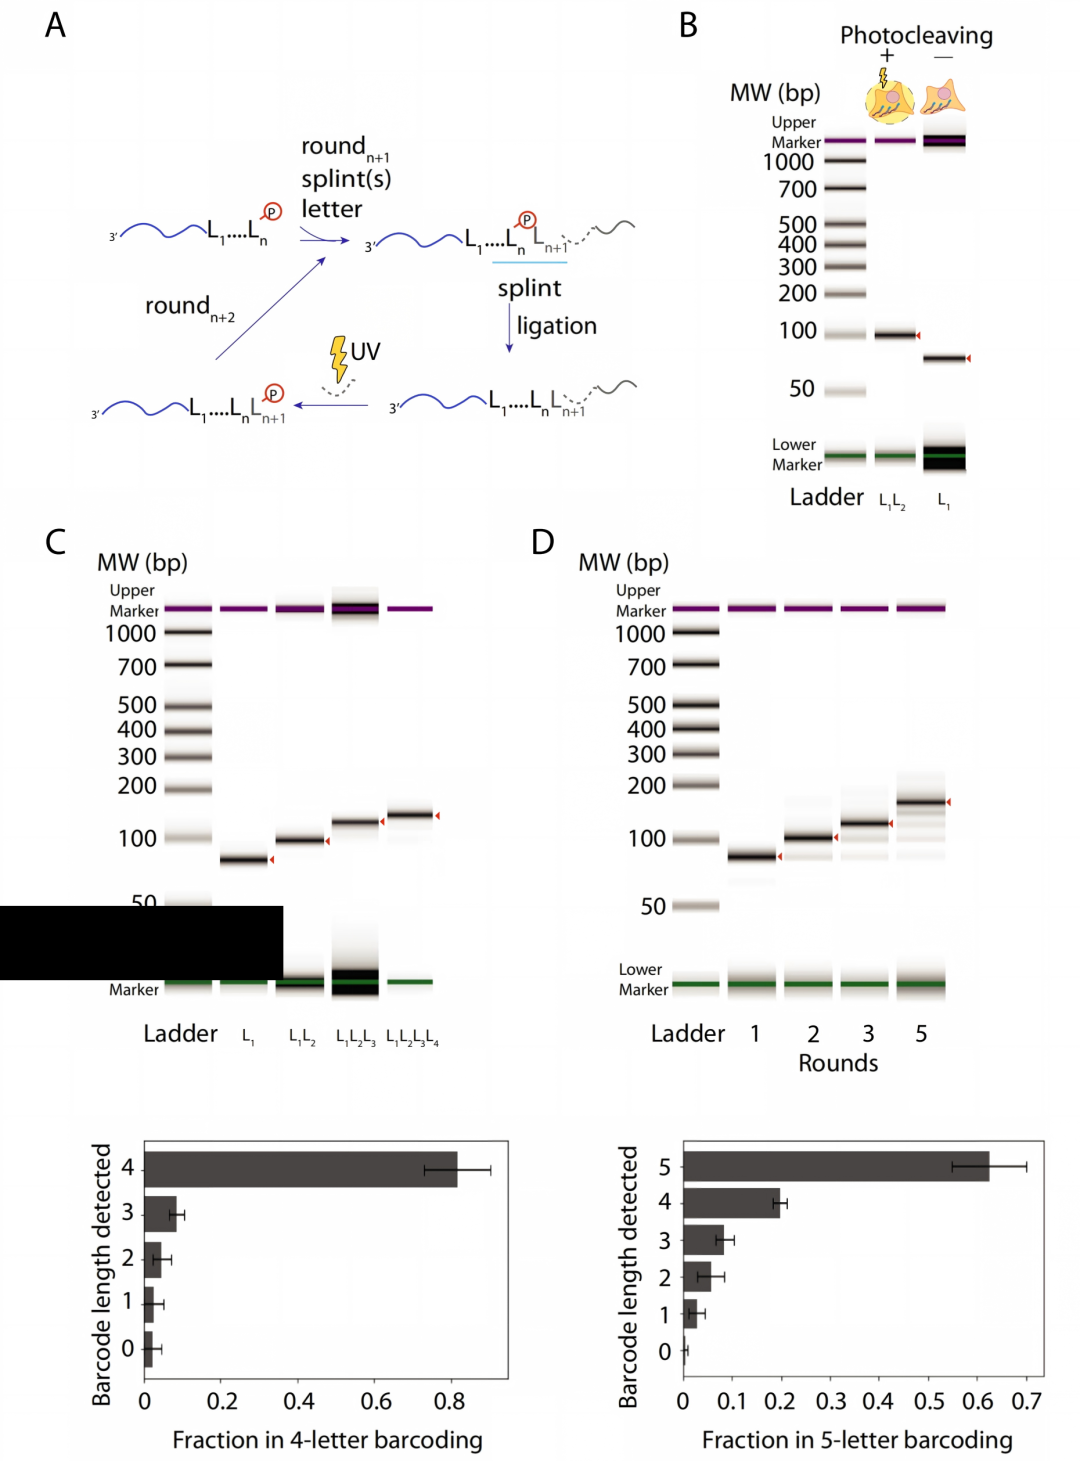
▲ 图2|光可裂解间隔基驱动的迭代光控连接。A:条码由字母 L1、L2…Ln 串联而成,每个待加字母带 PC(虚线)和夹板,连接后延长一位;UV 照射切断 PC,暴露 5'磷酸以开启下一轮。B:U2OS 细胞提取物的 TapeStation 凝胶——第一轮后照过 UV 的样本(L1L2)能加上第二字母,没照的(L1)则不能。C:连续构建 1、2、3、4 字母条码(每轮效率估为 94.9±2.6%,N=3)。D:用全部 4 个字母做多重连接,4 字母 5 轮后测序检测到 756±24 个唯一条码(理论 4⁵=1024),效率约 90.9±2.3%(N=3)。红箭头标出预期长度条带。
三、图案光实现空间定位:从数百微米到单细胞
化学跑通后,关键是证明它确实能"按位置写字"。团队用 DMD 投射不同直径的紫外光斑,在 U2OS 细胞上验证了从 220 µm、90 µm 到 20 µm(约一个单细胞尺度)的区域都能精准加字母。
脱靶控制是空间方法的命门。结果显示,紧邻被标记细胞(平均约 15 µm 外)的邻居细胞 FISH 信号几乎为零,脱靶率随距离迅速衰减——说明光照的空间选择性很干净。
- 4 个区域、双字母条码:两轮构建出的 2 字母产品占 69.2±5.0%,1 字母低于 30%,3 字母上限仅 3.5%;模型估算每轮靶向添加概率 d = 84.5±4.1%、脱靶 c = 2.5±1.8%。 - 64 个单细胞条码(4 字母 × 3 轮):3 字母产品占 58.3±9.4%,4 字母(即脱靶)仅 7.4±2.0%;d = 85.4±5.6%、c = 1.4±0.7%。
换句话说,在单细胞尺度上,它有超过八成的把握把正确的字母写到正确的细胞里,脱靶率压到了百分之一量级。
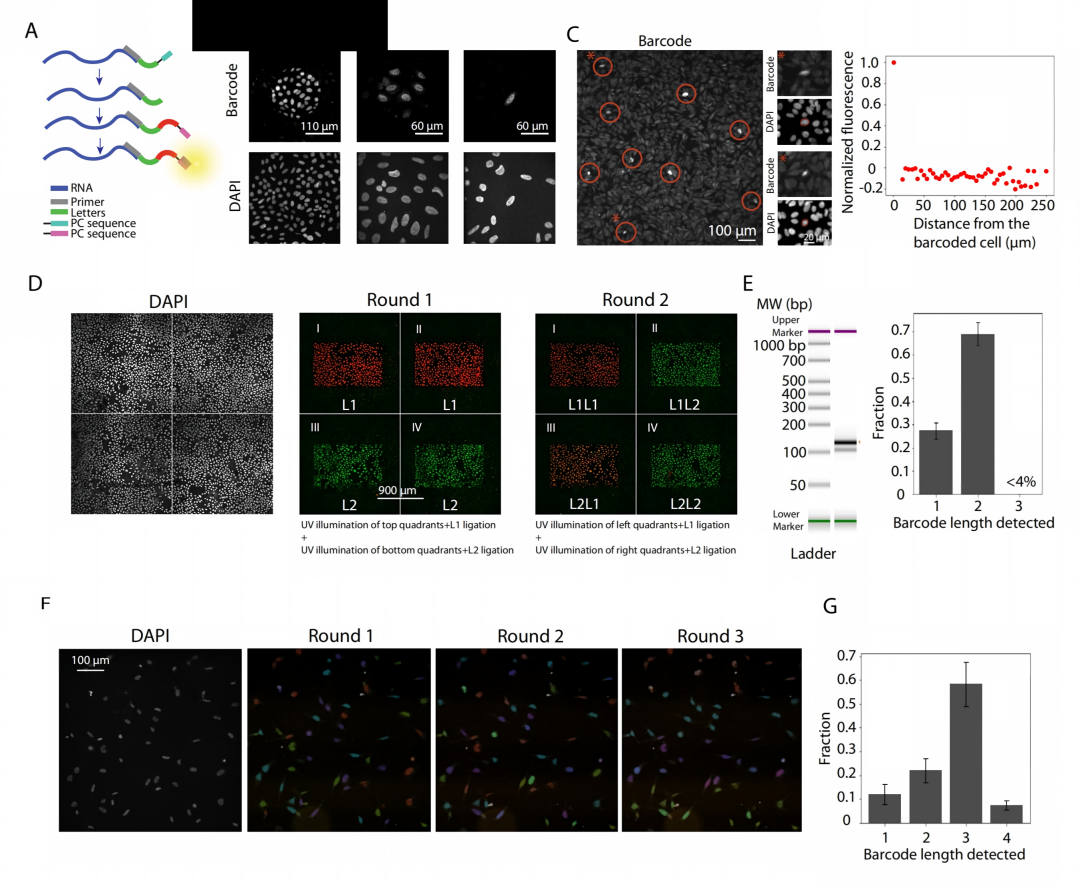
▲ 图3|图案化光实现空间可控条码。B:在直径 220 / 90 / 20 µm 区域加字母,FISH 信号(上)与 DAPI(下)对照,可见定位精度随光斑缩小到单细胞。C:左为脱靶光裂解/连接的距离依赖;右为距标记细胞 250 µm 内邻居细胞的归一化荧光,几乎为零。D–E:双字母在两区域构建 4 个唯一条码,3 字母产品 <4%。F–G:4 字母 3 轮构建 64 个单细胞唯一条码,双色 FISH 伪彩显示。
四、实战检验:人鼠混合培养的空间转录组
纸上谈兵不够,团队用一场"混居实验"来验证端到端能力:把人 U2OS 细胞种在样本下半(条码 L2L4)、小鼠 MEF 细胞种在上半(条码 L1L3),一起培养后做 MOLseq。
先查定位准不准(FISH 验证):L2L4 只有 5.0%、L1L3 只有 3.6%(N=2)出现在"错区"——少量错位很可能来自细胞在共培养中真的迁移,而非条码写错。
再查测序读得对不对:每个重复约 7000 万条 reads。在 L2L4 区域,95.7±0.9% 的 reads 映射到人基因组;在 L1L3 区域,92.7±1.2% 映射到鼠基因组(N=3)。作为对照,把两种细胞在各自隔腔里分开培养、直到测序前才合并,交叉映射率只有 4.7±0.4%——这说明前面的误差主要源于小鼠与人转录组的序列同源性,而不是条码本身的错误。平均每个区域检测到约 9500 个人基因、6300 个鼠基因。
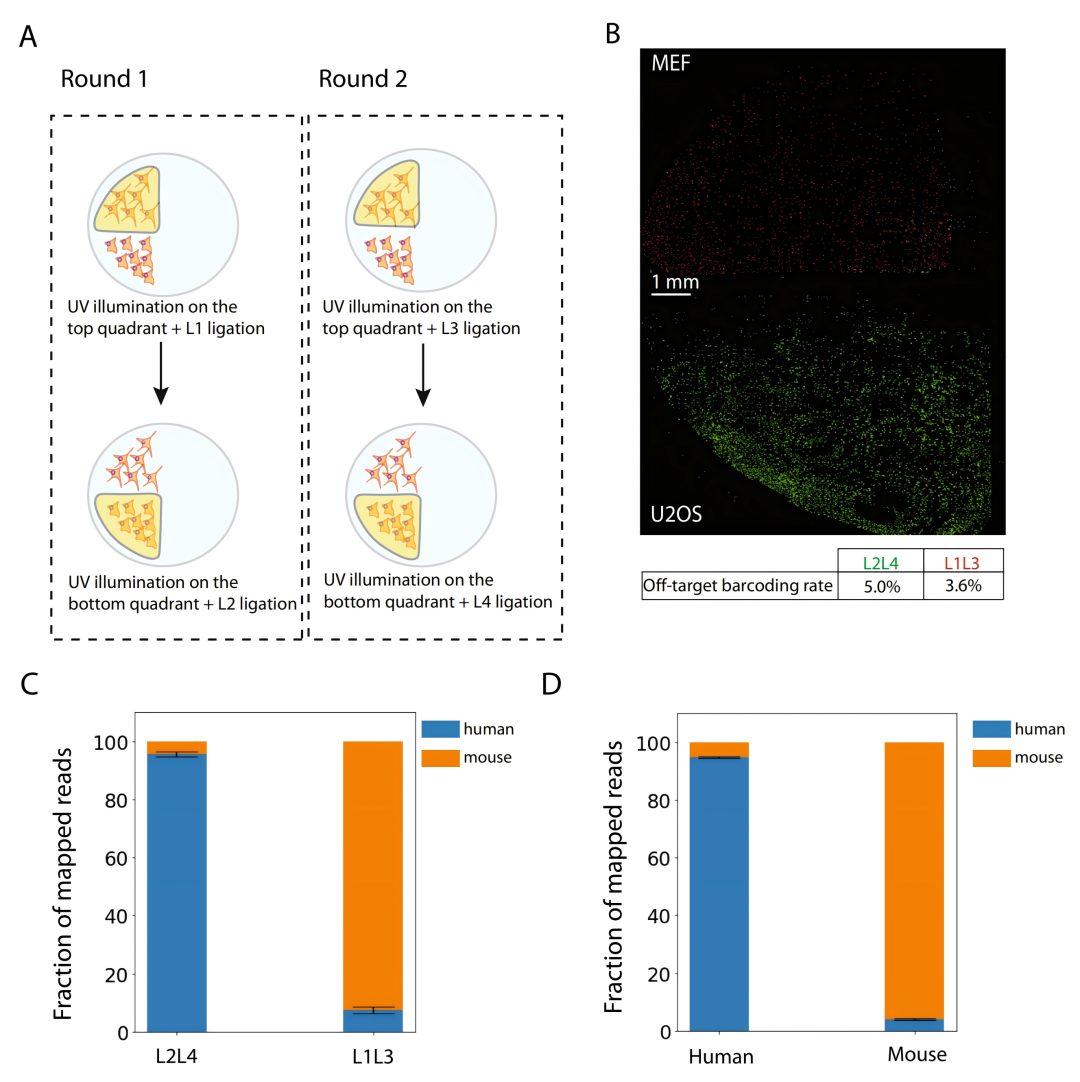
▲ 图4|MOLseq 空间分辨转录组验证。A:人(下,L2L4)与鼠(上,L1L3)细胞分置样本两端,用 4 字母构建两个区域条码。B:双色 FISH 图像(绿色 L2L4、红色 L1L3)及脱靶率量化——平均 5.0% / 3.6%(N=2)落在错区。C:含指定空间条码的测序 reads 中映射人/鼠基因组的占比,L2L4 中 95.7±0.9% 为人、L1L3 中 92.7±1.2% 为鼠。D:物理分离培养的对照交叉映射率仅 4.7±0.4%,证明误差主要来自鼠人转录组同源而非条码错误。
五、MOLseq 的能与不能:局限与展望
能力边界在哪?
- 可扩展:光控 + 测序,多重性随轮数指数增长,带纠错; - 效率高:每轮连接约 90%,5 轮就能拿到约 750 个空间条码; - 分辨率:靠缩小光斑可逼近单细胞,但受限于单细胞本身 mRNA 量很少。
目前的天花板?
- 轮数受限:脱靶光裂解、单细胞 RNA 量低,作者认为 ~5 轮是较合理的上限(全长保留约 60%)。想做到 10⁵ 量级的条码需要 10 种字母、约 50 步连接(约 3 天),整套流程约 6 天。 - 分辨率对比:相比成像法它无偏、通量高,但还难做到亚细胞级;相比非光控测序法它空间分辨率潜力更高,但分子提取效率偏低。 - 同期的 PHOTON 等方法能做到亚细胞分辨率,但多重性不足——MOLseq 的差异化优势正在于"多重 + 测序通量"。
六、这项技术对你的课题意味着什么
- 如果你要的是全转录组无偏扫描 + 还能区分相邻细胞甚至单细胞的空间位置,MOLseq 这类"光控条码 + 测序"正是为这个缺口而生,特别适合异质性高、细胞排布紧密的组织(肿瘤微环境、发育谱系、神经组织)。 - 如果你手头的科学问题已经锁定了少数靶点,成像法(原位杂交/原位测序)在分辨率与信噪比上仍更直接,不必为了"无偏"付出通量与流程复杂度的代价。 - 它和我们已经在做的 DIA 蛋白质组、非靶向代谢组是互补关系而非替代:蛋白/代谢告诉你"细胞此刻有什么",空间转录组告诉你"哪些细胞在哪些位置表达了什么"——多组学叠加,才是把机制讲圆的方向。