
 English
公共代谢组学数据再利用:网络整合 + 统一注释,把散落的研究串成一张图
一句话结论:Wieder 等人在 Metabolomics 2026 提出了一套网络整合框架——用 ChEBI / RefMet 统一注释、用代谢物共现网络把不同研究的差异代谢物连成图谱,让公共代谢组学数据真正可被二次挖掘。
公共代谢组学数据库正以前所未有的速度膨胀。单是 EMBL-EBI 的 MetaboLights,提交的研究数已超过 15,000,涵盖 7,000+ 物种和样本类型。但数据 deposited 只是第一步,真正的问题在于:
- 不同研究用了不同的仪器平台、色谱条件、数据格式; - 代谢物注释五花八门,有的用 ChEBI,有的用 RefMet,有的甚至没有标准 ID; - 提交者往往只上传自己关注的那部分显著代谢物,数据复用门槛很高。
这篇由帝国理工、EMBL-EBI、利物浦大学、UCSD 等团队发表在 Metabolomics 的工作,给出了一条可操作的解决路径。
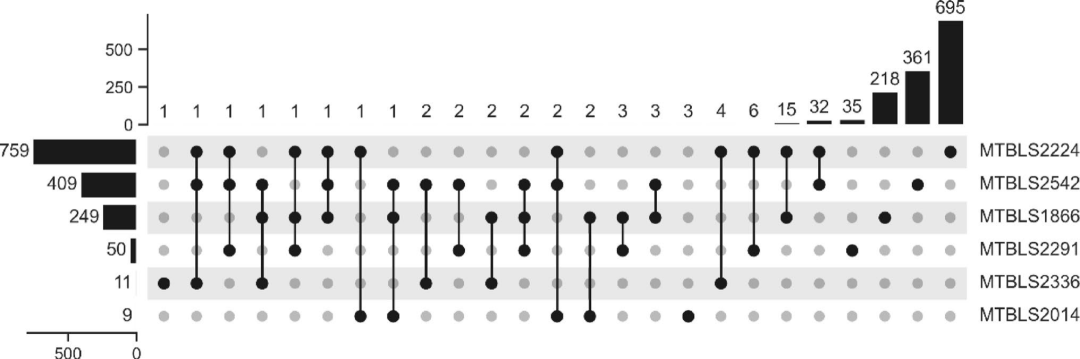
▲ 图1|6 个 COVID-19 血浆研究的差异代谢物共现概览(UpSet 图:纵向为各研究差异代谢物数,横向为跨研究共现组合)
1. 核心思路:两种网络,两类问题
作者把公共数据整合拆成两个互补的视角:
- 代谢物级 meta 网络:针对“同一科学问题”的少量研究,把各研究中差异显著的代谢物作为节点,若两个代谢物在多个研究中同时出现,就建立一条边。目标是找出跨研究的稳健代谢标志物或通路。 - 研究级全局网络:面向整个数据库的大量研究,以研究为节点,以它们检测到的代谢物重叠为边。目标是快速看清数据库里哪些研究技术路线相近、哪些疾病扎堆、哪些代谢物被测得最频繁。
两种网络都依赖同一个前提:代谢物标识必须统一。作者主要采用 ChEBI(用于 MetaboLights)和 RefMet(用于 Metabolomics Workbench)作为“通用货币”。
2. COVID-19 血浆案例:6 个研究怎么整合
作者挑选了 MetaboLights 上 6 个 COVID-19 血浆代谢组学研究(5 个 LC-MS + 1 个 NMR),覆盖健康/无症状对照到不同严重程度患者。对每个研究做 t 检验(FDR ≤ 0.05),差异代谢物数量从 9 到 759 不等,差异很大。
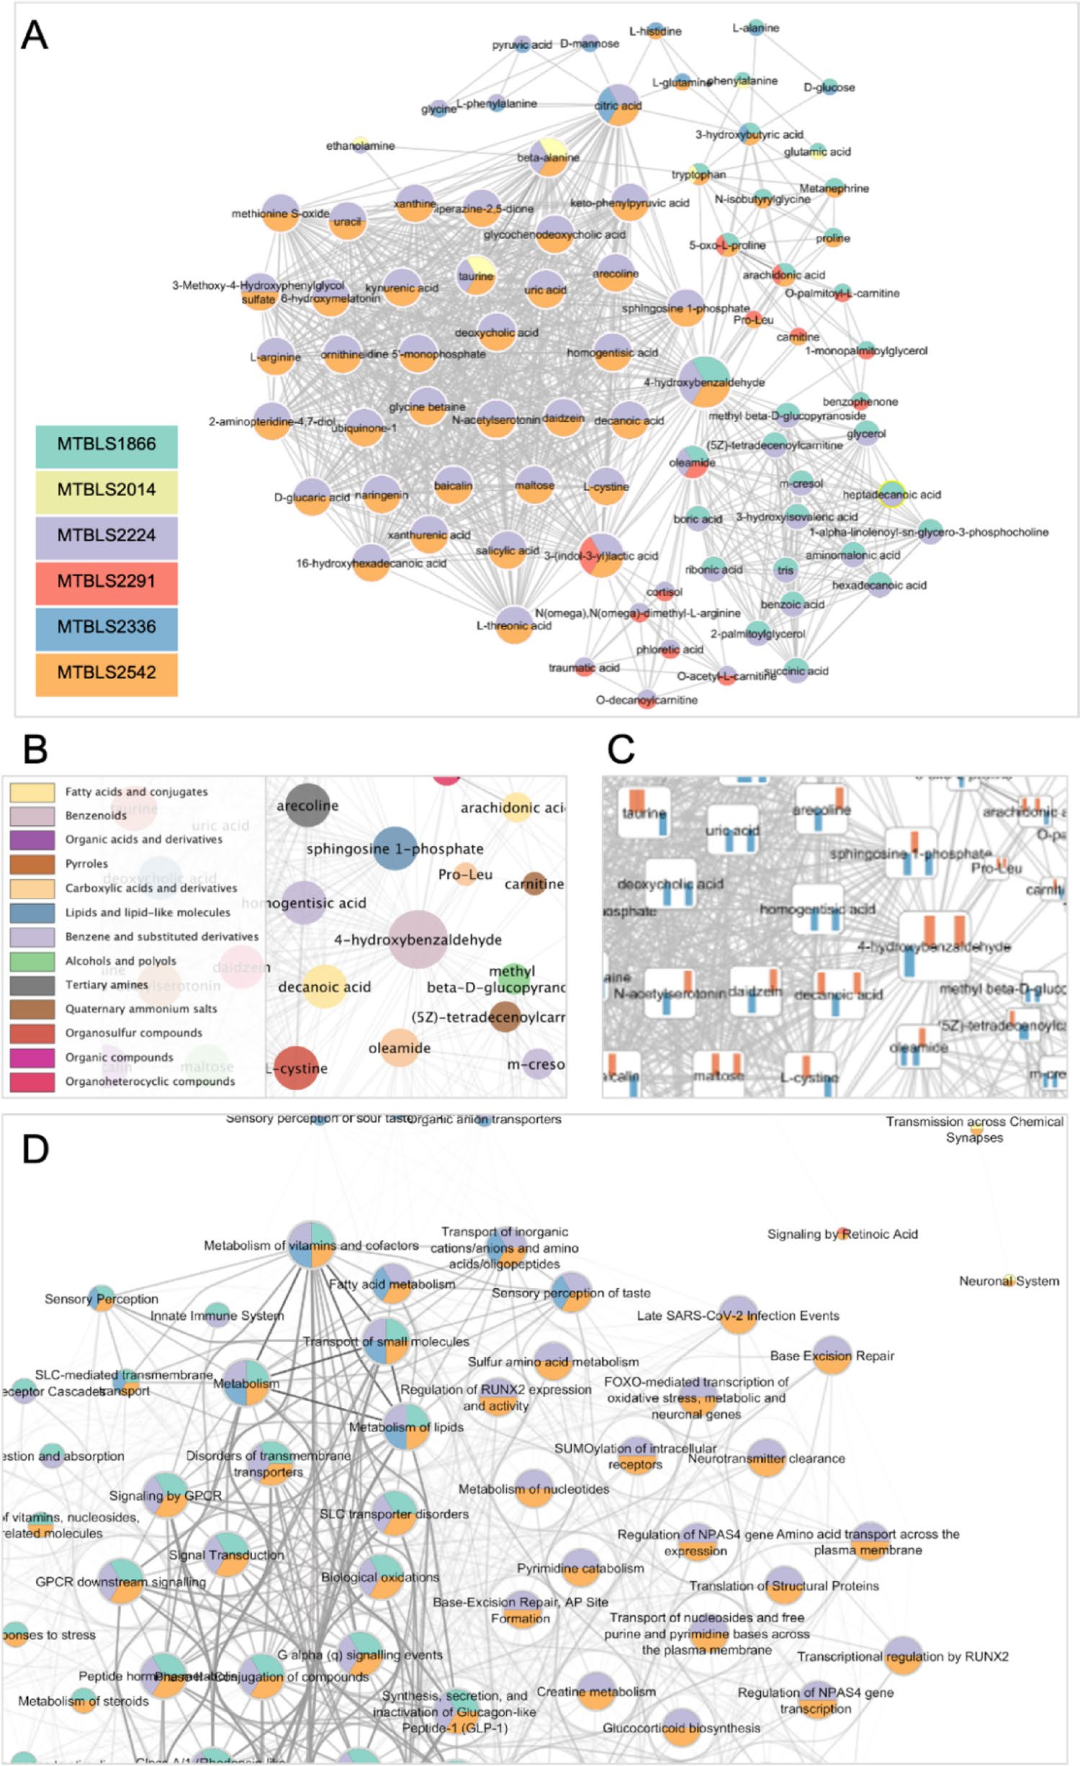
▲ 图2|COVID-19 代谢物级共现网络:节点=差异代谢物,边=跨研究共现(仅保留 ≥2 个研究共现的节点)
把它们投影到同一张代谢物级 meta 网络上后,结果变得直观:
- 网络共 82 个节点、907 条边(仅保留至少在 2 个研究中共同出现的代谢物)。 - 只有 10 个代谢物 在至少 3 个研究中同时差异显著,没有出现跨 4/5/6 个研究的“万能代谢物”。 - 几个高置信度节点包括: - oleamide(CHEBI:116314):3/6 研究中差异显著,是一种内源性大麻素样脂质,近期也被报道与 COVID 严重程度相关; - 4-hydroxybenzaldehyde:同样在 3/6 研究中出现; - 5-oxo-L-proline(焦谷氨酸):方向一致性高,被认为是 COVID-19 血浆中较稳健的升高标志物。
作者还专门做了通路级 meta 网络:用 ssPA-KPCA 把代谢物丰度映射到 Reactome 通路得分上,再在通路层面做差异检验。这样即使单个代谢物注释存疑,通路层面的生物学信号也更稳定。
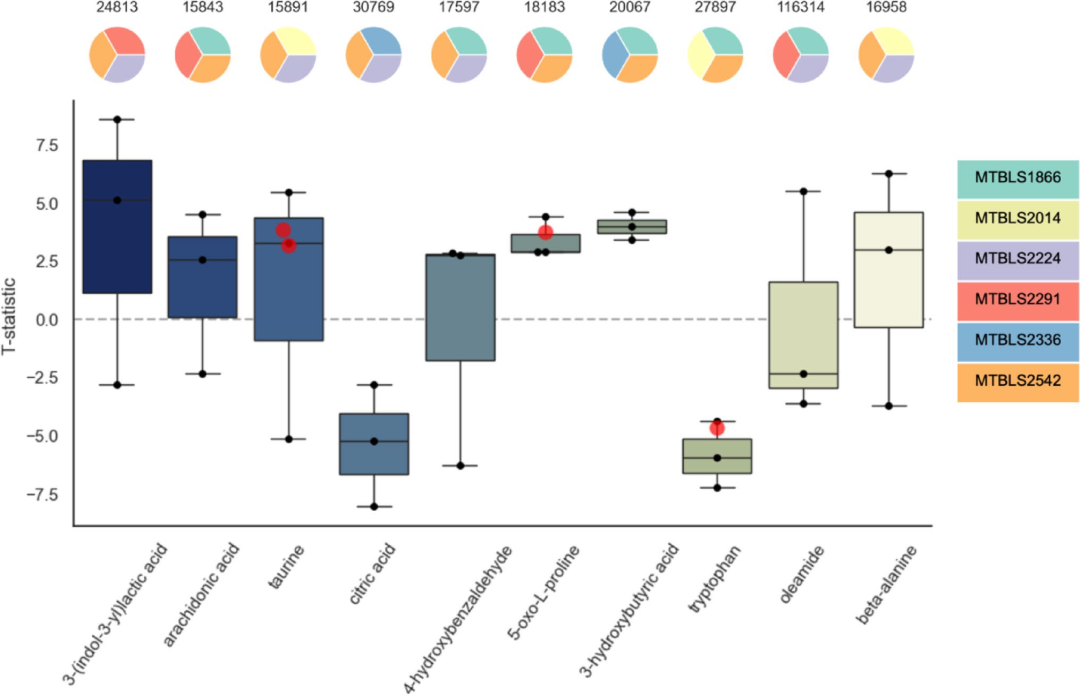
▲ 图3|外部验证:两个独立研究(MTBLS6739、MTBLS3852)中高共现代谢物的 t 统计量方向与幅度
3. 外部验证:新研究能否复现这 10 个代谢物
作者又找了两个未参与建库的独立 COVID-19 研究(MTBLS6739 和 MTBLS3852),专门看之前筛出的 10 个高共现代谢物在新数据里的表现。
箱线图显示,虽然研究规模、效应量、人群差异很大,但变化方向整体一致。其中 5-oxo-L-proline 在原 6 个研究中 3 个显著,再加上 1 个验证研究也显著,成为最被支持的候选标志物。这说明 meta 网络筛出来的节点确实有一定外推性。
4. 跨疾病比较:代谢物指纹能把疾病聚到一起
把视角放大到不同疾病,作者用 Metabolomics Workbench 中的研究构建了代谢物-研究二分网络,疾病包括:
- COVID-19 - hepatitis(肝炎) - tuberculosis(结核) - obesity(肥胖) - angina(心绞痛) - colorectal cancer(结直肠癌) - pre/post exercise(运动前后)
力导向布局下,疾病天然聚成几簇:
- COVID 研究自己抱团; - 肝炎 + 结核 等炎症性疾病靠近; - 心绞痛 + 运动前后 等心血管相关研究靠近; - 肥胖、结直肠癌 也有各自的聚集区。
这意味着,差异代谢物谱本身就能反映疾病的生物学亲缘关系。
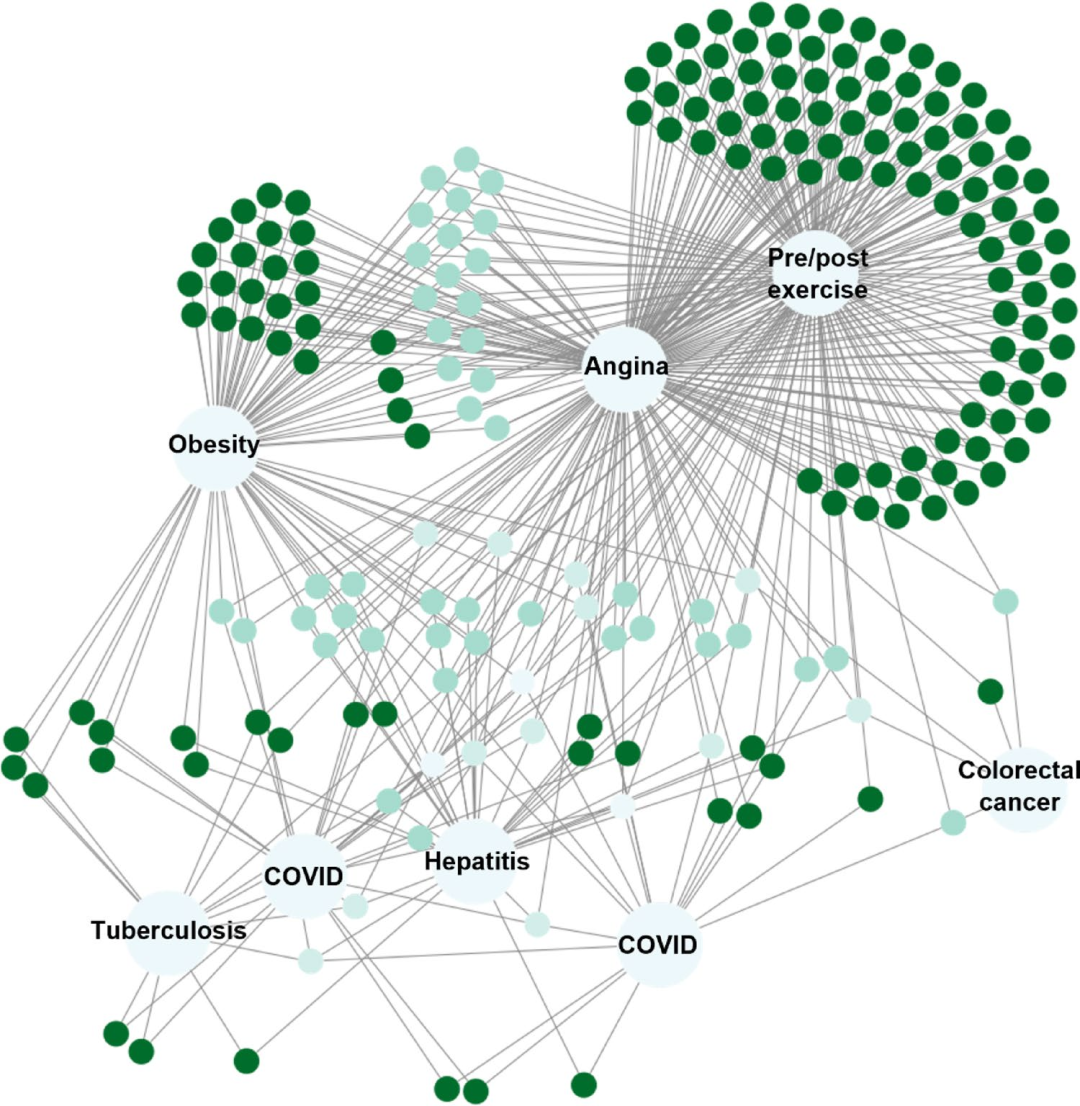
▲ 图4|代谢物-研究二分网络:不同疾病表型按代谢物谱自动聚类
5. 统一注释的威力:LAMP 让网络节点数从 40 涨到 320
公共数据最大的痛点是注释不一致。作者用 LAMP(Liverpool Annotation of metabolites using Mass spectrometry) 对可提供 mzML 的 LC-MS 研究做了重新注释。
效果立竿见影:
- MTBLS1866:提交者只给了 211 个 ChEBI,LAMP 后变成 837 个; - MTBLS2542:从 296 个变成 1,639 个; - MTBLS3852:从 51 个变成 456 个。
在 3 个可运行 LAMP 的研究中,总注释数和差异注释数平均分别提升了约 6 倍和 7 倍。重新构建 meta 网络后,节点数从原来的 40 个暴涨到 320 个,其中 90% 是新节点。L-phenylalanine 的研究证据数从 3 个增加到 4 个,跨研究一致性更强。
不过作者也提醒:LAMP 仅基于 MS1 精确质量(±5 ppm),属于 Level 3 注释,可能引入假阳性;若结合保留时间、MS/MS 可信度会更高。
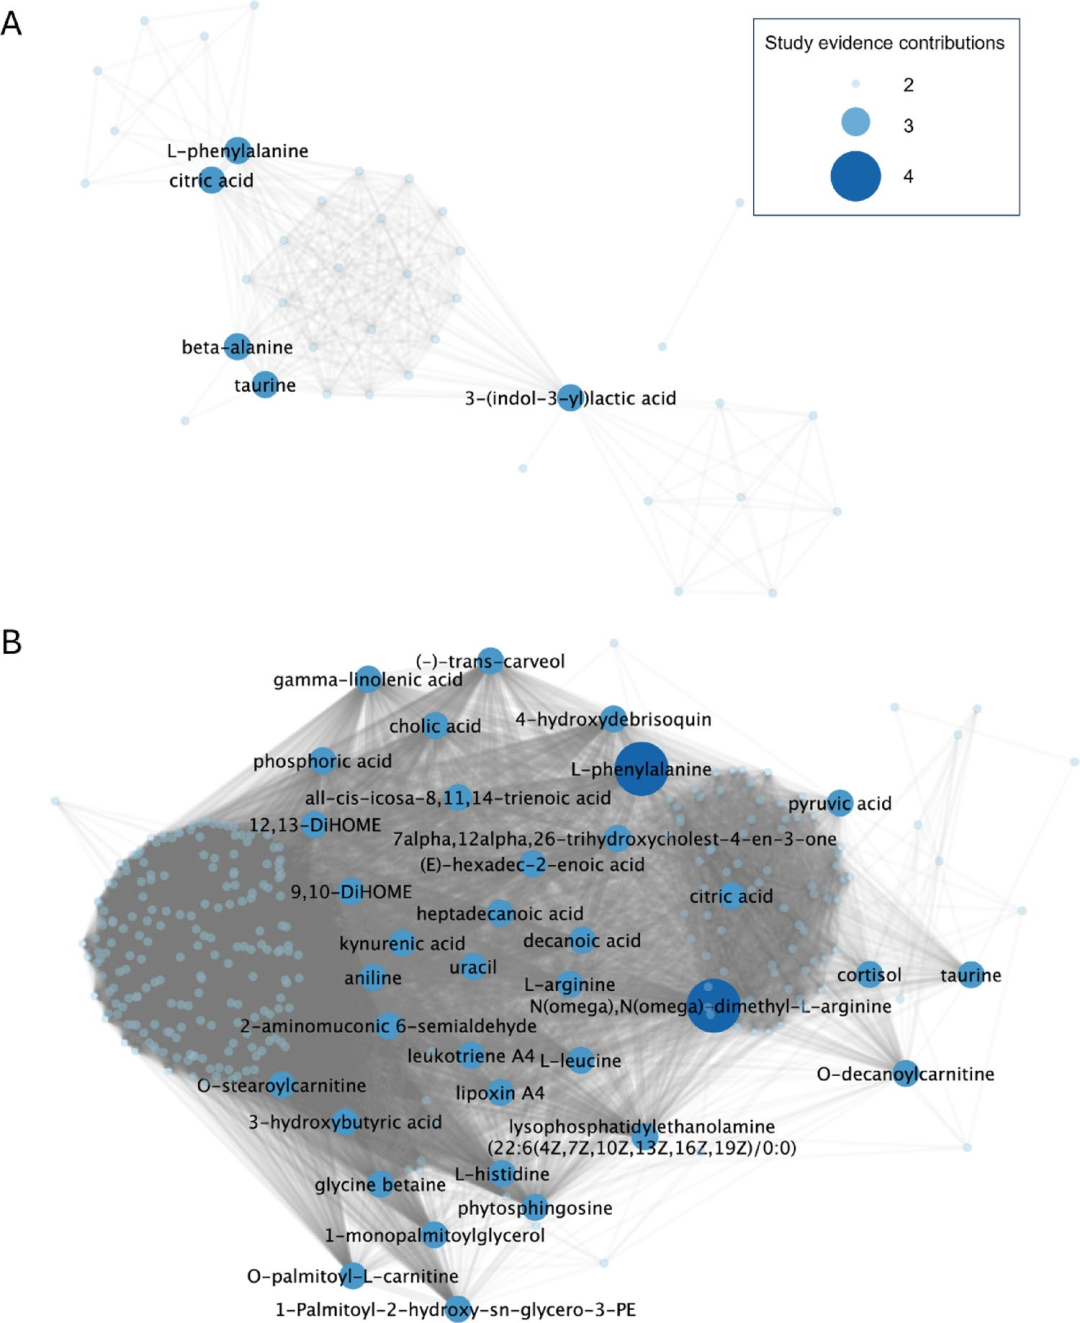
▲ 图5|LAMP 重新注释前后对比:meta 网络节点由 40 增至 320(其中 90% 为新节点)
6. 全局研究级网络:1,181 个研究的可视化地图
最后,作者用 Metabolomics Workbench API 抓取了 1,181 个 至少报告 100 个 RefMet 代谢物的研究,构建全局研究级网络。
统计结果:
- 每个研究的中位 RefMet 注释数为 221; - 出现频率最高的前 20 个代谢物基本是氨基酸和有机酸(苯丙氨酸、谷氨酸、色氨酸、谷氨酰胺等),集中在中心碳代谢; - 按色谱技术给节点着色后,力导向网络明显按技术聚类: - 反相色谱(RP)分成两簇,一簇偏脂质组学,一簇偏水溶性代谢物; - 水溶性代谢物又与 HILIC、GC 研究共聚。
这张图告诉我们:技术平台本身在很大程度上决定了你能看到哪些代谢物。做跨研究整合时,如果忽视技术差异,很容易把“方法学批次”误读成“生物学信号”。
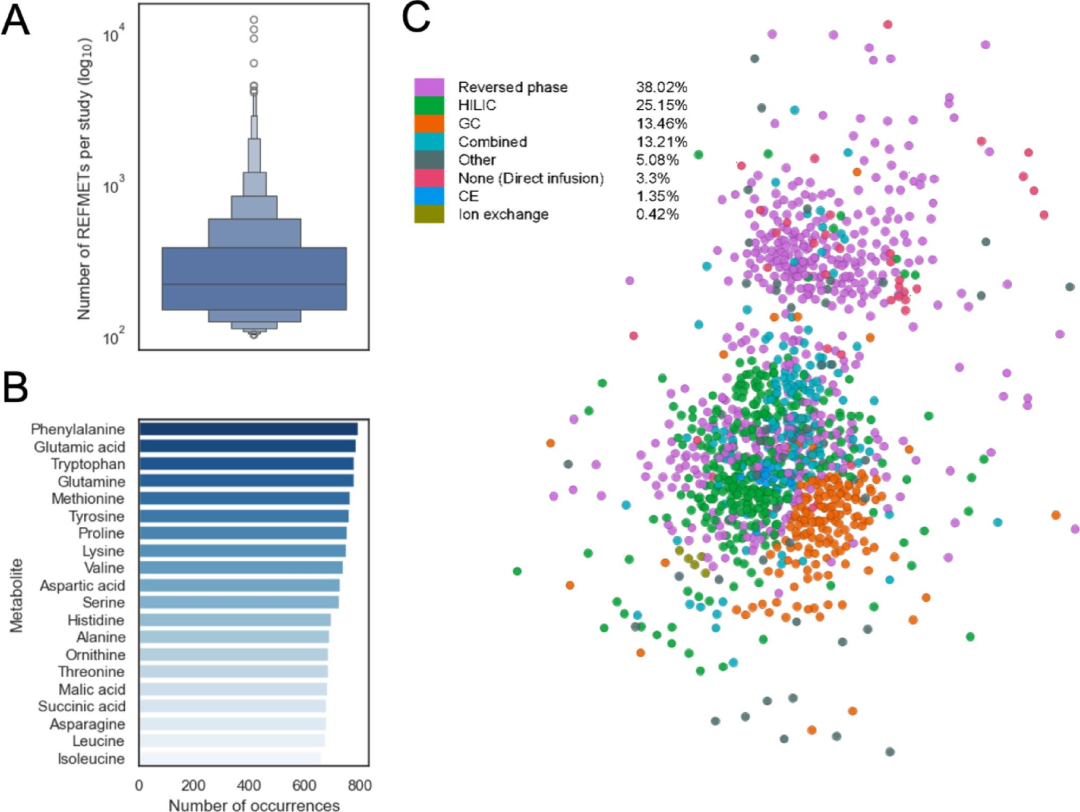
▲ 图6|全局研究级网络:Metabolomics Workbench 1,181 个研究的 RefMet 注释分布与技术聚类
7. 我们能带走什么
- 数据复用第一步是注释统一:ChEBI、RefMet 这类标准 ID 是跨研究对话的基础;没有统一 ID,再好的算法也连不起来。 - 网络是直观的整合语言:代谢物共现网络能把“某研究显著”这种孤立信息,变成“多个研究共同支持”的集体证据。 - 通路层面能缓冲注释噪声:当代谢物注释置信度参差不齐时,通路级 meta 网络可以聚合同一功能模块内的信号,降低假阳性影响。 - 公共数据有巨大价值,但受限于提交质量:注释少、元数据缺、文件格式不统一仍是主要瓶颈。未来需要自动重注释流程 + 标准提交规范双管齐下。
8. 工具已开源
作者把整个流程打包成了一个 Python Dash web app,并用 Docker 容器化发布,方便跨平台部署。代码和示例数据可在 GitHub 获取:
https://github.com/EloisaRL/Metabolomic-data-analysis-app/tree/main
如果你想尝试把自己的数据与公共研究并联分析,这套框架是个不错的起点。