
 English
不还原、不衍生:226 个标准品如何把 N-糖异构体彻底分开
一句话看懂:糖链(N-糖)是蛋白质上最复杂、最"善变"的翻译后修饰之一——同一个分子量下面,可能藏着几十种结构不同、功能也完全不同的异构体。2026 年发表于 Nature Communications 的 N-glycopedia 工作,用 226 个纯化 N-糖标准品 搭配 多孔石墨化碳液相色谱-三重四极杆质谱(PGC-LC-QqQ-MS),把"不还原、不衍生"的天然 N-糖链结构分析做成了一套可复现、可跨实验室迁移的靶向方法:183 个独特结构、429 条非定时 SRM 通道,只靠"保留时间 + 结构特异性碎片 + 碰撞能量指纹"三个维度,就能把结构异构体钉死。它最大的突破不是"测到了什么",而是证明了不做还原、不牺牲结构信息,同样能达到临床级质谱方法的精密度。
一、糖基化的"最后一公里":为什么 N-糖这么难测
如果要给蛋白质翻译后修饰排一个"难度榜",糖基化(glycosylation)几乎稳居榜首。它参与细胞识别、蛋白质折叠、免疫应答,是生命体最通用的"信息标签"之一。但和磷酸化、乙酰化这类"单点、确定"的修饰不同,糖基化的复杂程度是指数级的:
- 单糖种类多(甘露糖、唾液酸、岩藻糖、半乳糖、N-乙酰葡糖胺……); - 连接方式多(同两个糖,可以是 α2,3 也可以是 α2,6 连接); - 分支拓扑多(同样组分,天线接在哪个臂上,结果完全不同)。
这就带来了糖组学(glycomics)最核心的难题——结构异构体(isomer)。两个糖链的分子量可以精确到小数位完全一致,但在色谱上保留时间、在质谱碎裂上碎片比例、在生物学功能上都可能南辕北辙。传统质谱分析给出的往往只是组成(composition)信息,也就是"这个糖由哪几种单糖、各几个组成",却无法回答"它们是怎么连起来的"。而真正决定生物功能的,恰恰是后者。
这不是一个纯学术问题。 糖基化异常与肿瘤、自身免疫病、以及先天性糖基化缺陷病(CDG)等都关系密切。在生物药领域,糖型更是绕不开的核心质量属性:单克隆抗体上的岩藻糖化与否,直接决定其 ADCC 效应强弱;唾液酸化程度影响半衰期;而重组蛋白(比如疫苗用的刺突蛋白)由哪种宿主细胞表达,糖型就会出现系统性差异,进而影响免疫原性与药效。换句话说,能不能准确、可重复地"读"出糖链的完整结构,直接关系到疾病标志物的发现与生物药的质量控制。
更现实的问题是:临床诊断领域早已把三重四极杆质谱的 SRM(选择反应监测)模式奉为金标准——前体离子、产物离子、碰撞能量、保留时间四个变量同时锁定,灵敏度、特异性、重复性都无可挑剔。但这样一套方法在糖组学里始终缺位,原因很简单:SRM 方法是"针尖对麦芒"的靶向方法,它要求预先知道每一种结构的碎裂指纹——而这需要大量纯化的结构确证标准品。O-糖领域已有成熟先例,N-糖却一直没有对应的体系。
这项工作的起点,就是补齐这块拼图。
二、旧路径的代价:为什么"还原"这一步值得省掉
在 N-糖分析中被视为"标配"的一步,是还原(reduction)。糖链从蛋白质上释放(PNGase-F 酶切)后,还原端是一个活性半缩醛,会自发形成 α 和 β 两种端基异构体(anomer)。在 PGC 色谱上,这两种人为产生的异构体常常被分开,造成同一个结构出现两个峰——于是大家在进样前用硼氢化钠把还原端"封掉",让它只出一个峰。
除此之外,传统糖组学还大量依赖化学衍生化:全甲基化(permethylation)、还原端标记(reducing-end tag)等,目的都是提高检测灵敏度、便于结构解析。但这些操作本身会引入人为副产物、增加前处理复杂度,甚至丢失部分结构信息(比如某些连接键在高 pH 下会发生"剥离反应"peeling)。
于是研究的核心命题变得很清晰:能不能既不还原、也不衍生,直接在天然状态下把 N-糖链分开并测准? 如果能,样品前处理会大幅简化,结构信息也得以完整保留——这正是 N-glycopedia 想证明的事。
三、工作流:从"组成"到"结构"的三级跳
研究团队首先从五家供应商收集了 226 个纯化的 N-糖标准品,覆盖寡甘露糖型(oligomannose)、杂合型(hybrid)和复杂型(complex)等主要类别,要求纯度 > 95%。整套流程可以拆成三步:
第一步,组成筛查。 所有标准品先过一遍 SUGA(Swift Universal Glycan Acquisition)方法。这是一个流动注射(flow injection)流程,样品不经色谱柱直接进 MS,每个样品只需 3 分钟,因此 226 个标准品的初筛在 12 小时内就能跑完。SUGA 的作用是确认组成纯度、并记录每个标准品产生的产物离子谱——为后续的 SRM 通道提供"种子"。由于源内碎裂率极低(< 1%),一些合成杂质也能被顺带识别出来。
第二步,加入"标尺"。 为了能用保留时间(RT)这一维度区分异构体,每个标准品在复溶时都加入了部分水解的葡聚糖梯子(dextran ladder)。葡聚糖梯子提供了一系列已知葡萄糖单位(GU)的参照峰,可以把不同批次、不同梯度下的保留时间归一化成可跨实验比较的数值。
第三步,靶向结构分析。 基于 SUGA 观察到的产物离子,为每个标准品建立专属的 PGC-LC-QqQ-MS SRM 方法:一个前体 m/z,搭配 13 个精挑的产物离子,每个产物离子还要在 9 个碰撞能量(10–90 V)下逐一优化。色谱端则采用多孔石墨化碳(PGC)柱,柱温 90 ℃,流动相添加 5 mM 六氟异丙醇(HFIP)和 5 mM 丁胺,pH 9.4——正是这套"柱温 + pH + 流动相"的组合,把端基异构体的分离效应彻底消除了。
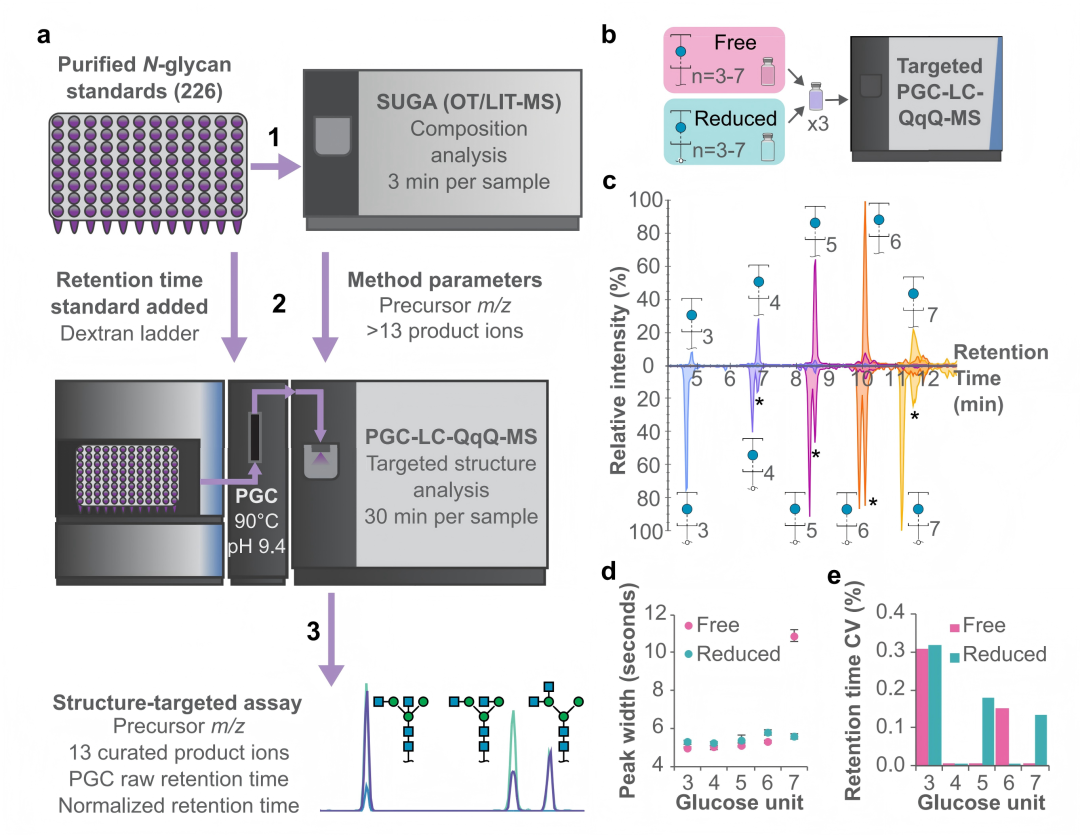
▲ 图1 非还原糖链分析的核心工作流。a 用 226 个纯化 N-糖标准品搭建 N-glycopedia 的数据采集流程,先经 SUGA 做组成分析,再做靶向 PGC-LC-QqQ-MS 结构分析;b 还原型与非还原型糖链在天然 PGC-LC-MS 上表现等效;c 还原型与非还原型葡聚糖梯子给出等效色谱图(* 号标注非还原梯子的同位素干扰);d 两种形式的峰宽基本一致(仅 GU7 略宽),误差棒为标准差;e 两者的保留时间同样一致。糖链结构按 SNFG 命名法绘制。
结果非常关键:还原型与非还原型葡聚糖梯子在峰宽和保留时间上几乎完全一致(仅 GU7 出现峰宽翻倍,其余参数相同)。这意味着,只要柱温、pH、流动相调对了,不做还原也能拿到"一个结构一个峰"的干净结果——anomeric effect 这个人造难题被直接绕开了。研究进一步发现,柱温对较大糖链的峰形影响显著,70 ℃ 与 90 ℃ 都能给出紧凑的峰。
四、把异构体分开:PGC 的分离力到底有多强
解决了"端基异构体"这个人为干扰后,真正的对手来了:天然存在的结构异构体。
研究团队做了两重验证。第一重是跨供应商的一致性验证。226 个标准品来自五家厂商(Vendor A–E),各自合成路线不同,但结构有重叠。以 G36191CD(一个双天线半乳糖封端的 N-糖)为例,五家都生产这个结构。把它们混合后进样,只得到一个单峰、没有任何异构杂质——说明不同来源的标准品结构一致、可互通。团队进一步验证了 7 组重叠结构,全部得到单一主峰,其中包括 Vendor C 提供的稳定同位素标记糖链的共洗脱。为了直观展示各家覆盖面的重叠与差异,作者用韦恩图刻画了五家标准品库的结构交集。
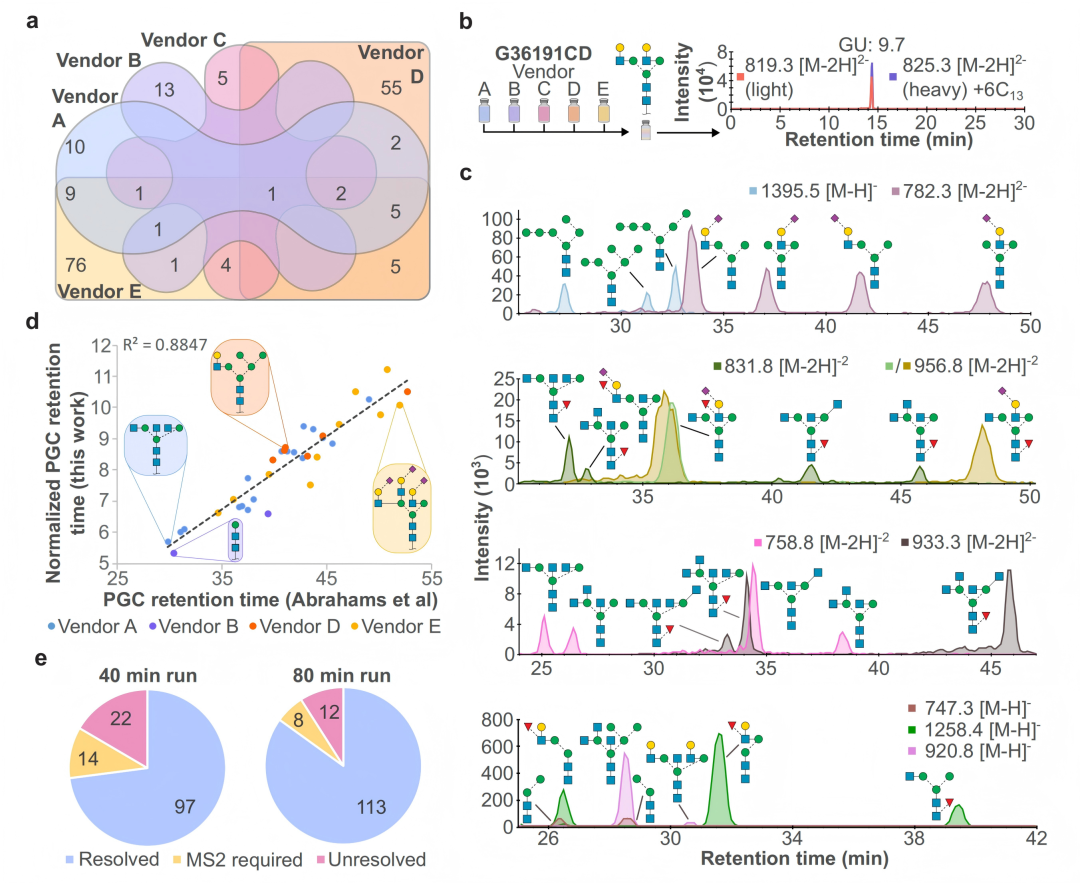
▲ 图2 天然 PGC-LC 对糖标准品的系统性基准测试。a 韦恩图展示不同供应商之间结构身份的重叠;b 无论合成路线如何,各家都能产出同一纯结构;c 天然 PGC-LC-MS 能拆分高难度的异构体混合物,涵盖甘露糖化、唾液酸化、岩藻糖化、半乳糖化和 GlcNAc 化;d 梯度优化降低了对 MS2 的依赖;e 本工作测得的归一化 PGC 保留时间与 Abrahams 等已发表数据高度一致(R² = 0.8847)。
第二重是真实的异构体混合物拆分。团队挑战了包含甘露糖、唾液酸、岩藻糖、半乳糖、GlcNAc 的连接与拓扑异构体混合物,绝大多数都能在色谱层面基线分离。唯一例外是两条"臂位置不同、但唾液酸和岩藻糖连接相同"的结构(m/z 956.8),它们仍需借助 MS2 才能区分——这也恰好说明了"色谱 + 质谱"双维度互补的必要性。
梯度长度也被系统评估:把采集时间从 40 分钟延长到 80 分钟,异构体解析率从 72% 提升到 85%(相对提升约 18%)。
最后一个亮点是与既有数据库的对接。PGC 保留时间本身是结构确证的重要维度,社区已有 GlycoStore 这样的资源库。团队把本工作测得的归一化 RT 与 Abrahams 等发表的原始 PGC RT 做对比,得到强正相关(R² = 0.8847)。这有两重意义:其一,证明非还原糖链与还原糖链的保留行为几乎一致;其二,本工作的糖库不是"另起炉灶",而是能直接叠加、扩充到既有资源之上。偏差较大的主要出现在少甘露糖型(paucimannose)和高唾液酸化糖链上。
五、碰撞能量:异构体判读的"指纹维度"
如果说保留时间是第一维度,那么结构特异性碎片 + 碰撞能量(CE)就是第二维度,也是这套方法真正的"灵魂"。
团队在优化每个产物离子的 CE 时,观察到一个有意思的对比:
- 对整组产物离子的总强度而言,最佳 CE 与前体 m/z 之间存在不错的正相关(R² = 0.79),说明总量是可以大致预测的; - 但对单个产物离子而言,最佳 CE 与产物 m/z 之间几乎不相关(R² = 0.25)。
这个反差极具启发性。在 SRM 蛋白质组学里,肽段的产物离子 CE 往往可以凭 m/z 稳妥估算——因为肽段是线性的。而糖链是非线性、高度分支的,存在多个竞争性的碎裂通道,因此每一个产物离子都必须实验性地逐一优化。这种"不可预测性"看似麻烦,却恰恰可以被反过来利用:不同连接方式的糖,其碎裂能量曲线不同,这本身就是一张结构指纹。
最漂亮的例子是唾液酸连接异构体。两条仅唾液酸连接方式不同的糖链,在代表"同一糖苷键断裂"的产物离子上 CE 曲线完全重合;但一旦看唾液酸自身的碎片,曲线立刻分开——α2,3 连接的唾液酸,比 α2,6 连接需要高出约 10 个 CE 单位才能充分碎裂。因此,尽管两者在 60 CE 下强度相当,只要分别选用 50 CE(对 α2,3)和 70 CE(对 α2,6),特异性就能被显著放大。
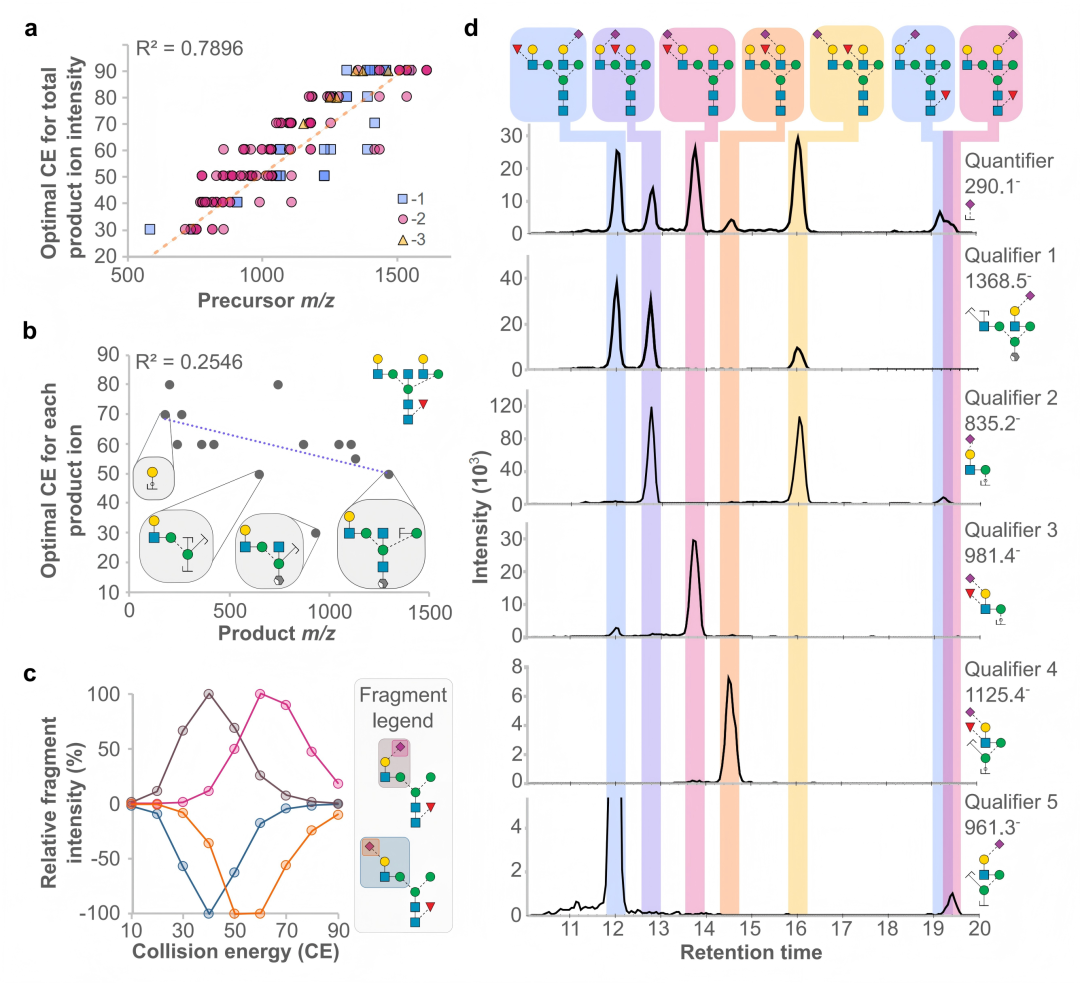
▲ 图3 碰撞能量(CE)优化揭示碎片强度的结构依赖性,用于异构体区分。a 达到最大总产物离子强度的最佳 CE 可由前体 m/z 预测;b 单个产物离子的最佳 CE 与产物 m/z 相关性很弱;c 不同单糖连接方式呈现截然不同的 CE 曲线;d 借助糖表位特异性的产物离子组合实现糖链异构体区分。
在此基础上,团队建立了一套"定量离子 + 定性离子"的判读体系。以 7 个在岩藻糖和唾液酸位置/连接方式上各异的异构体为例:quantifier(定量离子) 是所有结构共有的丰度碎片(290.1 m/z),负责灵敏;qualifier(定性离子,共 5 个) 则各自只对一部分结构有响应——Qualifier 1 对应"一臂唾液酸、另一臂岩藻糖"的 3/7 结构,Qualifier 2 对应"唾液酸化的非岩藻糖 α1,3 臂",Qualifier 3/4 分别区分 α1,3 臂与 α1,6 臂修饰,Qualifier 5 专测"非岩藻糖化、带 α2,6 唾液酸的 6 臂"。这样一套组合拳,就能同时测量每个糖链上的每一个基元(motif),再汇总成对整体结构的判断。
这一点与传统的非靶向诊断离子思路形成鲜明对照:SRM 方法里的定性离子是在采集之前就定义好的,可重复、可标准化,而不是事后从谱图里"找"出来的。
六、N-glycopedia:一个能跨实验室跑起来的靶向方法
把上面所有原则落地,团队定义了一套单一的 PGC-LC-QqQ-MS N-糖检测方法:429 条非定时(unscheduled) SRM 通道,覆盖 183 个哺乳动物 N-糖结构。这里"非定时"是个刻意的设计——不做保留时间窗调度,方法就能适配各种不同配置的色谱系统,也保留了发现并定量"库外结构"的灵活性。由于 N-glycopedia 覆盖的 93 个糖组成在生物合成上是相互关联的,那些没有用来建库的异构体同样可以被检测和定量。
数据分析端走的是透明、去厂商绑定的路线:
用 GlyCombo 识别组成、挑选最强 MS2 谱; 用 GlycoWorkBench 做注释、并生成 GlyTouCan 登录号(如 G36191CD)——这是 glycan 结构的全球唯一"数字身份证"; 用 Skyline 完成保留时间归一化、CE 优化、谱库构建、质量过滤与定量。
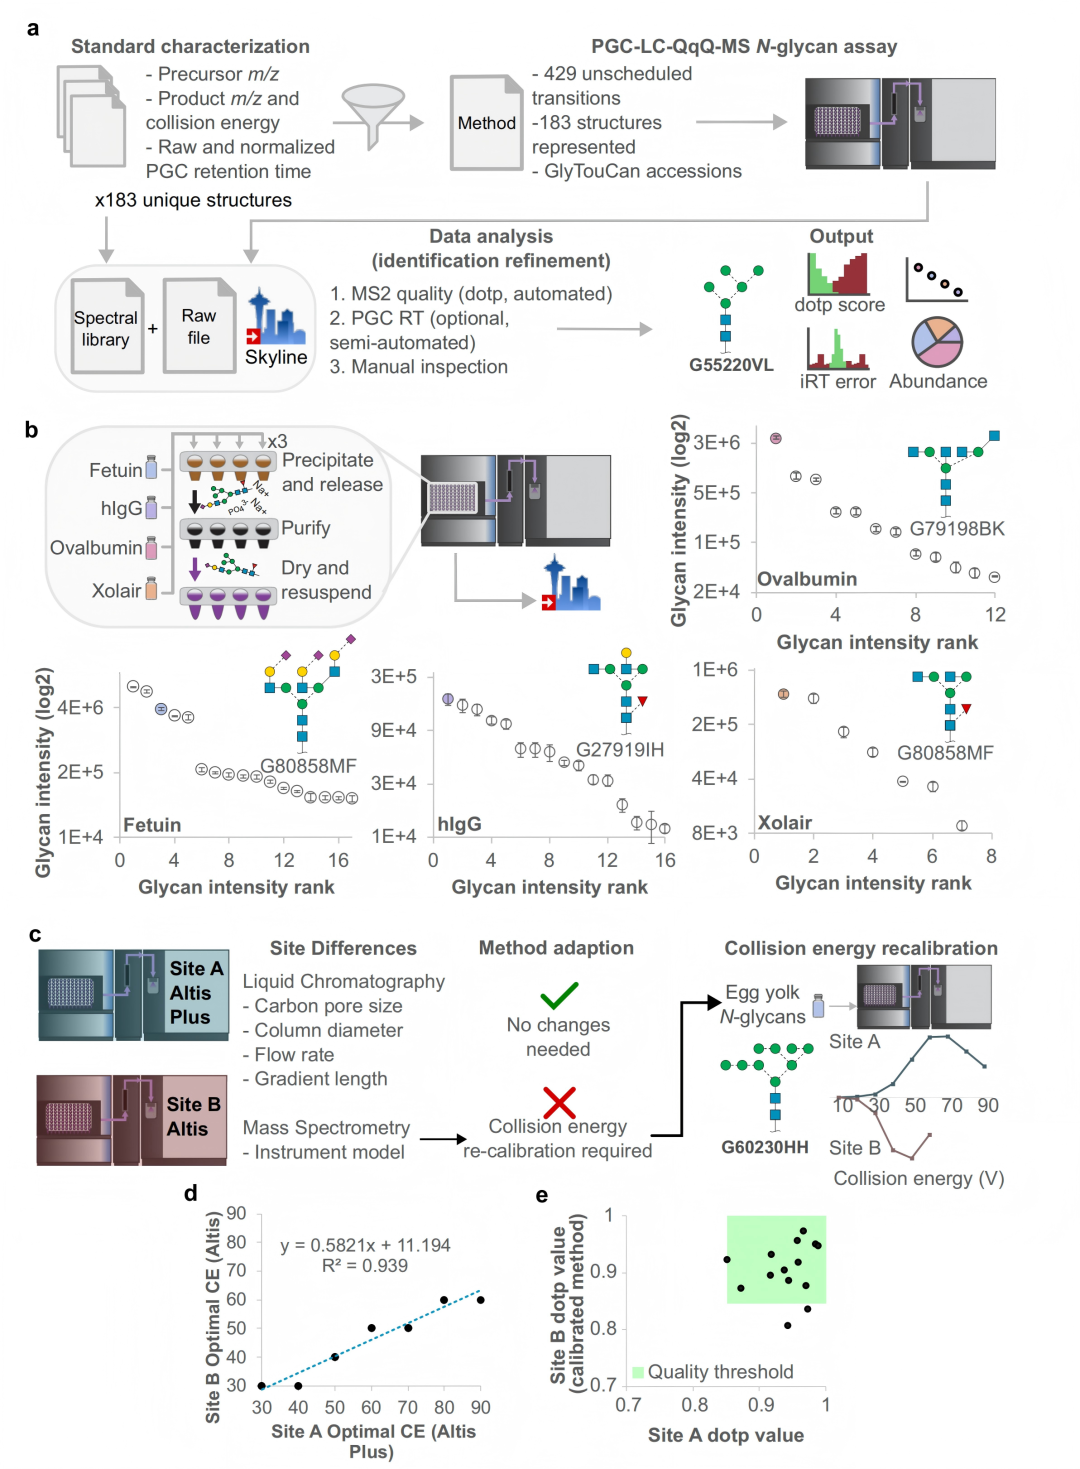
▲ 图4 N-glycopedia 让靶向糖结构分析在多种糖蛋白、不同实验室之间实现可复现。a 色谱库被筛选、定义为一套 N-糖结构检测方法,并配合快速数据分析与结果语境化;b 从纯化糖蛋白释放的 N-糖在三技术重复中的结构定量,证明方法可重复(点代表均值,误差棒为标准差);c 在不同实验室间迁移方法时,碰撞能量重校准是唯一的适配步骤;d 方法适配用的最佳碰撞能量关系图;e 牛胎球蛋白(fetuin)的 N-糖鉴定质量在两个站点之间保持一致。
性能指标相当硬核:
- 原始 RT 波动极小(CV < 1.2%),但梯度长度和数月的柱况变化会带来结构特异性漂移;用葡聚糖梯子归一化后,两个月的漂移被大幅压下去; - 对一组纯化糖蛋白做三重复定量,除个别结构外,在跨越两个数量级的动态范围内总变异 CV < 20%——这已经满足临床质谱方法的要求; - 定性判读的阈值同样明确:SUGA 用 idotp ≥ 0.9,SRM 谱库匹配用 dotp ≥ 0.85。
跨实验室迁移能力是这篇文章最实用的一笔。由于 SRM 通道是非定时的,两个站点在色谱配置上的差异无需修改方法;唯一需要重校准的是碰撞能量——因为质谱型号不同(Site A 用 Altis Plus,Site B 用 Altis)。团队用廉价的蛋黄 N-糖(结构简单、不含异构体)在 Site B 采集 CE 曲线,与 Site A 的标准品 CE 曲线对比,得到强线性关系(R² = 0.939),据此把整套 SRM 的 CE 值"翻译"到新仪器上。重校准后,产品离子 dotp 分数提升约 5%。用牛胎球蛋白做双站点验证时,除两个 N-糖外,其余全部达到"可信鉴定"的质量阈值。
七、用起来:四类真实样本的"糖谱"
方法建好了,接下来是证明它有生物学价值。团队把它用在四类糖基化状态各异的样本上。
1)重组蛋白表达系统:宿主决定糖型。 SARS-CoV-2 刺突蛋白分别在人源 HEK293、仓鼠 CHO、昆虫 SF9 中表达,得到三条完全不同的 N-糖谱:
- HEK293 谱最丰富,以复杂型双天线糖为主,同时含相当比例的寡甘露糖型——与已发表的糖蛋白组数据吻合,但这里给出了结构层面的分辨率(而不仅是组成); - CHO 更均一,单一的 α2,3 双天线 N-糖占所观察峰面积 30% 以上; - SF9 约 70% 是核心岩藻糖化的少甘露糖型结构,伴随少量寡甘露糖和复杂单天线型。
这对生物制药领域意义直接:同一个蛋白、不同表达宿主,糖型天差地别,而糖型直接影响疗效与免疫原性。
2)人免疫球蛋白:IgA / IgG / IgM 的结构差异。 三者在类别层面就有区别,更关键的是结构特异性的定量差异:IgA 中有 3 个 N-糖丰度至少高出 2 倍,其中一个平分型双天线 N-糖强度高出 10 倍;IgG 中有 4 个 N-糖至少高出 10 倍,以半乳糖或 GlcNAc 封端的双天线糖为主;而寡甘露糖型和杂合型糖链在 IgM 中显著高出 10 倍以上。这些差异与三类抗体截然不同的免疫功能、以及糖链可及性高度契合。
3)糖基化缺陷细胞系:直接"看见"通路断点。 Pro5(对照)、Lec2(唾液酸缺陷,Golgi 内 CMP-NeuAc 偏低)、Lec8(半乳糖缺陷,UDP-Gal 偏低)是 CHO 经典突变体。以往这些细胞系的糖谱多停留在 MALDI-MS 的组成层面,结构存在歧义。用 N-glycopedia 一看:Pro5 中唾液酸化显著高于 Lec2 与 Lec8;半乳糖化的三天线、单天线和杂合型糖链在 Pro5 与 Lec2 中升高(Lec2 因半乳糖底物无法被唾液酸化而更高);而少甘露糖型、杂合型和 GlcNAc 封端糖链在 Lec8 中显著更多。核苷酸糖转运缺陷对糖链加工的影响,被结构层面直接印证。
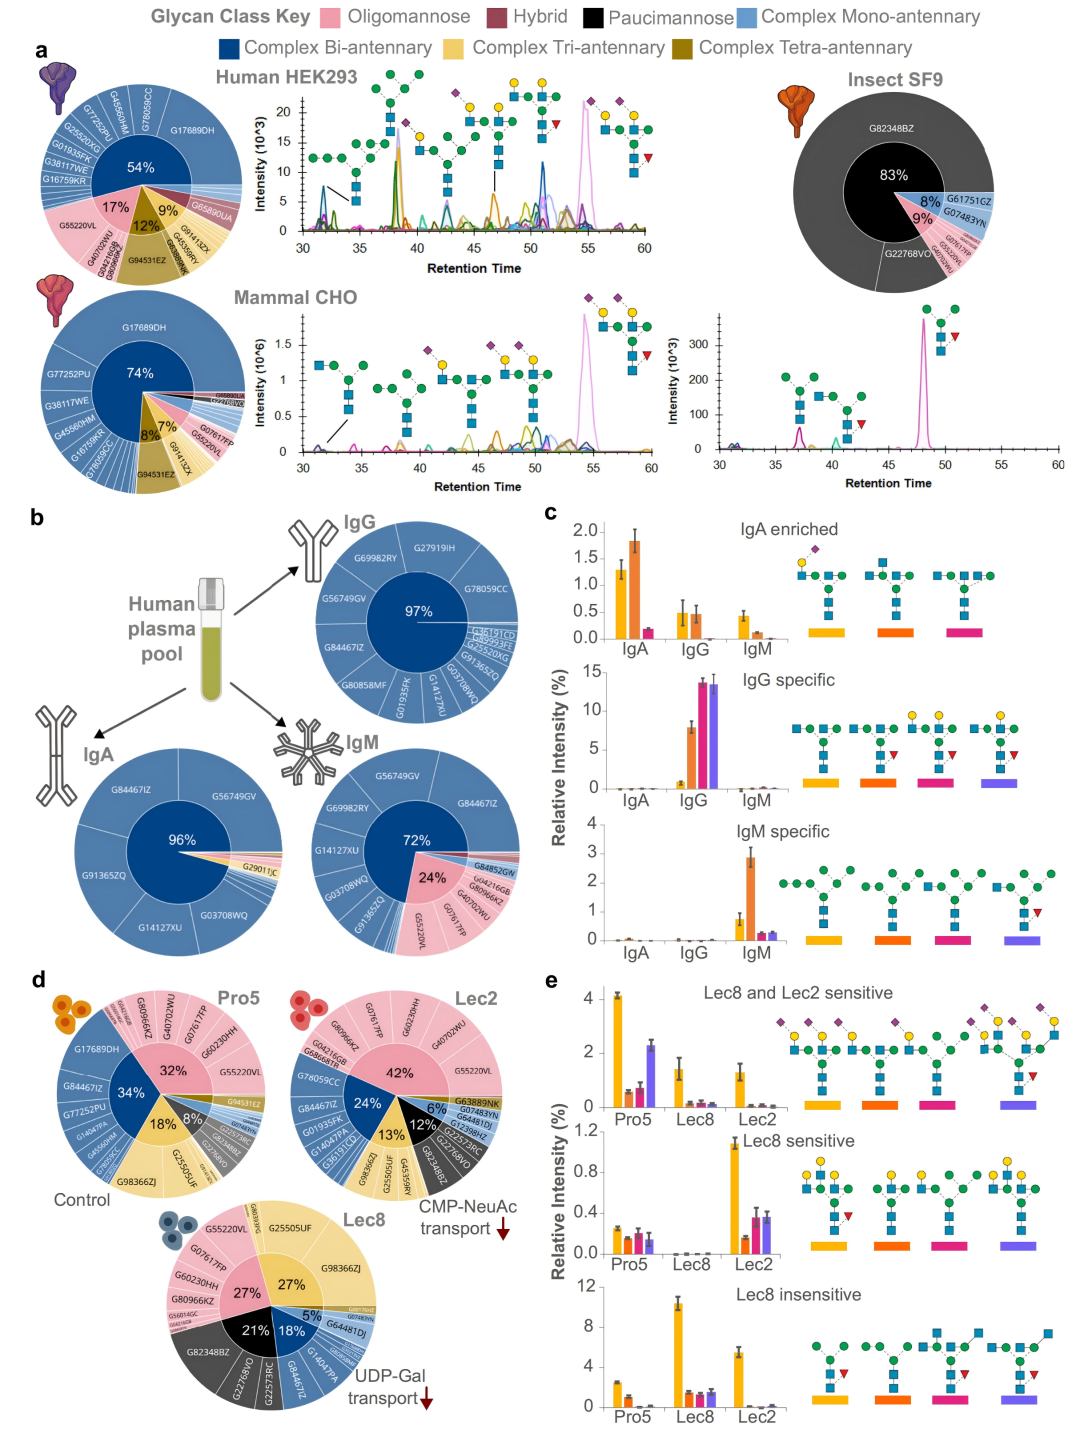
▲ 图5 靶向定量数据覆盖重组蛋白表达系统、纯化人免疫球蛋白和受扰动细胞系,揭示结构特异性的表达差异。a 在 SF9 昆虫细胞、CHO 哺乳动物细胞和 HEK293 细胞中表达的 SARS-CoV-2 刺突糖蛋白的三技术重复 N-糖谱;b 用人血浆池中的 N-糖类别谱、以及 c 结构丰度(三技术重复)区分 IgA、IgG、IgM;d 限制核苷酸糖向高尔基体的转运,会引起 N-糖类别谱和 e 结构丰度的剧烈变化(三技术重复)。柱状图(c、e)表示技术重复(样品前处理与 LC-MS)的均值,误差棒为标准差。
八、连接的桥梁:和糖蛋白组学、生物药质控、临床标志物的关系
N-glycopedia 测的是"从糖蛋白上释放下来的一池 N-糖",属于糖组学(glycomics)的范畴。而与之互补的另一个方向是糖蛋白组学(glycoproteomics)——它关心的是"哪个蛋白、哪个位点上、连着哪一种糖"。两者是"全局糖谱"与"位点归属"的关系:糖组学告诉你样本里有哪些结构,糖蛋白组学告诉你它们挂在哪儿。而糖蛋白组学在做位点结构注释时最缺的,恰恰就是一份经过纯标准品验证的结构-碎裂指纹字典。从这个角度看,N-glycopedia 不只是糖组学的资源,也是糖蛋白组学上游的"参照系"。
对生物药质控而言, 这篇文章给出的两个能力正是刚需。其一是宿主糖型的结构级分辨:HEK293、CHO、SF9 三大常用表达系统产生的糖型差异,文章用一张张结构清晰的糖谱摆在眼前——这正是细胞株筛选、工艺放大、批次一致性评价需要的信息。其二是方法的可迁移性:一个方法从研发实验室搬到 QC 实验室、从一台仪器搬到另一台仪器,往往就是最费时费力的环节;而本文证明,只要重校准碰撞能量、其余(梯度、柱规格)几乎无需改动,就能把方法"带走"。对做检测服务的实验室来说,结构分辨率 + 跨平台可复现性,恰恰是服务质量的两条硬指标。
对临床标志物而言, IgG 糖型(如去半乳糖化、平分型 GlcNAc)早已是炎症、自身免疫病等领域公认的标志物。要把这类标志物做成常规检测,方法必须同时满足高特异性(不能把异构体混为一谈)和高精密度(CV 要足够低)。本文中"跨两个数量级动态范围、CV < 20%"的定量表现,说明结构级的糖链 SRM 检测已经有资格去叩临床检测的门。
对珍贵样本而言, "不还原、不衍生"省掉的不只是一步操作,而是整条链路的风险与损耗——更短的流程、更少的人为副产物、更小的样本需求量。对于临床穿刺、微量生物药样品这类"样本比方法金贵"的场景,这种前处理的简化是实打实的价值。
九、这项工作真正改变了什么?——意义、局限与启示
它证明了"少做一步"反而更强。 不还原、不衍生,意味着前处理更简单、人为副产物更少、宝贵的结构信息不再在衍生化中丢失。同时非还原糖链与还原糖链保留行为近乎一致,使得新数据能与既有糖库(如 GlycoStore)无缝衔接、叠加增益,而不是推倒重来。研究还确认,在所用 LC-MS 条件下未观察到"剥离反应"(peeling),方法稳定性有保障。
它把"标准品 + 靶向质谱"的临床转化路径讲清楚了。 高灵敏度、高特异性的三重四极杆 SRM,配合透明的第三方软件(Skyline)和标准化的谱库,让糖链结构鉴定第一次具备了走向常规监测与临床应用的形态——只需要一次 CE 重校准,就能在另一个实验室的仪器上复现。
它的边界同样诚实。 因为方法是基于标准品的,那些目前买不到真实标准品的糖链——比如发生乙酰化、硫酸化、磷酸化修饰的糖——暂时还无法纳入;未靶向、未表征的结构可能带来少量干扰,但这属于整个糖组学领域的共性挑战,而非本方法的专属短板。下一步的方向也很明确:为每个糖类引入稳定同位素标记标准品,就能进一步实现绝对定量,让 N-glycopedia 的价值从"社区参考资源"继续往"定量金标准"演进。
对组学检测的启示。 从蛋白质组到代谢组再到糖组,"从组成走向结构、从相对走向绝对、从单实验室走向跨平台标准化"是共同的演进方向。N-glycopedia 给出的范式是:用高质量标准品把碎裂指纹固化下来,用保留时间与碰撞能量两个正交维度锁定结构,再用开放的谱库让方法可迁移、可复现。 这套思路的原则——标准化、可迁移、透明可审计——完全可以外推到 O-糖、糖脂释放的寡糖乃至游离寡糖,为刻画复杂糖组提供通用的分析骨架。
当糖链结构越来越被承认为生物功能的关键决定因素时,像 N-glycopedia 这样的资源,正在把"我们能测到什么糖"这件事,从模糊的组成清单,变成清晰的结构地图。
术语速查
- N-糖(N-glycan):通过 N-糖苷键连接在蛋白质天冬酰胺(Asn)残基上的糖链,是糖基化最主要的形式之一。 - 组成 vs 结构:组成只说明"由哪些单糖、各几个"构成;结构还必须说明连接位置与方式(接在哪根臂、α/β 构型、2→3 还是 2→6)。同组成、不同结构即为异构体。 - PGC(多孔石墨化碳):一种对糖链异构体分离能力极强的色谱固定相,是糖组学分离的核心。 - QqQ / 三重四极杆:以高灵敏、高特异性著称的质谱,是靶向定量与临床检测的主流平台。 - SRM(选择反应监测):同时锁定"前体离子 → 产物离子"的靶向采集模式;本方法用 429 条非定时通道,以适配不同实验室的色谱配置。 - CE(碰撞能量):控制离子碎裂程度的能量参数。糖链因结构非线性、碎裂通道竞争,每个产物离子都必须单独优化 CE——这也成为区分连接异构体的额外维度。 - GU / 葡聚糖梯子:以葡萄糖单位标定保留时间的参照体系,用于跨批次、跨梯度的保留时间归一化。 - quantifier / qualifier:定量离子(负责灵敏度)与定性离子(负责特异性)的组合,在灵敏度与专属性之间取得平衡。 - GlyTouCan:全球统一的糖链结构登录号体系,为每个独特结构分配唯一"数字身份证"。 - SUGA:Swift Universal Glycan Acquisition,一种快速流动注射式糖组成筛查方法(每样品约 3 分钟)。 - dotp:基于归一化谱对比角度的谱库匹配打分,用于自动化判定鉴定质量(SRM 阈值 ≥ 0.85)。 - SNFG:糖链符号命名法,用统一的图形符号表示单糖种类与连接方式。
本文依据:Ashwood C. & Cummings R.D. N-glycopedia: libraries for native N-glycan structural analysis. Nature Communications (2026) 17:6665. DOI: 10.1038/s41467-026-73091-3。