
 English
跳过肽段鉴定:ProFormer 用 Transformer 直接从质谱信号判别样本身份
一句话看懂:蛋白质组分析的常规流程是"碎裂肽段→鉴定序列→比对蛋白→统计比较",其中 MS2 碎裂测序既耗时、又受鉴定假设限制。德国癌症研究中心(DKFZ)海德堡团队提出了 ProFormer(Proteome transFormer),一个基于 Transformer 的深度学习流水线,它绕开肽段与蛋白鉴定,直接拿 MS1 层面的肽离子表格特征(m/z、保留时间、离子淌度、强度)来判别样本身份。核心结论有三点:① 在与 14 种 ML/DL 架构的同场竞技中,ProFormer 在批间漂移的测试集上取得最高 84.0% AUC,且唯一做到"验证集≈测试集",说明它真正抗过拟合、抗批次效应;② 用可学习的 patch merger 替代传统的"图像式网格分箱",能把 MS1 数据压成高判别力、可解释的 token——在单细胞蛋白质组上最高拿到 100% AUC,并能识别出训练浓度 1/10 的 IFN-γ 效应(检出限 9.44 ng/mL);③ 在 490 人的血浆蛋白质组临床数据中,它把"重度 COVID-19"从轻度感染、脓毒症、其他重症感染与健康人中区分出来,测试集 AUC 86.3%,在保证 100% 敏感度的同时排除 46% 的假阳,且借助 SHAP 把预测拆解到单肽分辨率、指向补体与凝血通路的真实生物学改变。
一、蛋白质组分析的"最后一公里"卡在哪
先厘清一个基础流程。蛋白质组学主流采用"自下而上(bottom-up)"策略:把蛋白酶切成肽段,经液相色谱(LC)按保留时间分离,进入质谱按质荷比(m/z)测定;MS1 层面记录完整肽离子的信号强度,MS2 层面则通过碎裂肽段、读取序列信息来推断肽段与蛋白身份。
这套策略极其强大,但它有两个绕不开的结构性瓶颈:
- 速度瓶颈:MS2 需要对肽离子逐个迭代碎裂测序,耗时,直接限制了分析通量。 - 假设瓶颈:肽段鉴定建立在若干前提之上(酶切规则、数据库、打分阈值……),这会"框住"我们对质谱信号全貌的观察。
关键洞察在于:很多实际问题(样本来自哪种细胞?患者处于哪个疾病状态?)并不需要先知道每个肽段叫什么名字——仅凭 MS1 的肽离子"指纹",就可能完成判别。于是,如何直接利用 MS1 信号做样本分类,成为一个极具吸引力的方向。
已有尝试中最主流的是把 MS1 数据转成"图像":把邻近的肽离子信号分箱到一个规整网格里,做成热图样输入,再喂给卷积神经网络(CNN)。但作者指出这条路有三个隐患:
肽离子信号与"邻域"并无关系
——图像里相邻像素是相关的,质谱里相邻信号却未必,基于位置的分箱可能损失信息; 图像转换把架构锁死在固定特征数
上,无法接纳离子淌度(ion mobility)这"第四维"分离; 过往 CNN 研究普遍缺少独立测试集
,其高准确率是否源于过拟合、能否扛住批次效应,一直存疑。
二、核心思路:把 MS1 肽离子信号当作"表格"喂给 Transformer
ProFormer 的破局点,是换一种数据表征方式。
它不再把肽离子"压成图像",而是保留为表格(tabular)输入:每一条肽离子就是一行,由 m/z、保留时间(RT)、离子淌度(IM)、强度(intensity)等若干 MS1 特征构成。任何数量的特征维度都能塞进去,天然支持离子淌度;更重要的是,它保留数据完整性、不做先验分箱。
那么高维数据怎么降维?研究的核心设计是一个可学习的 patch merger(补丁聚合器)。它用可学习的权重矩阵,把成千上万条肽离子信号按相似度"加权归并"成一小批 patch(补丁),再转成 token 输入 Transformer。与固定网格分箱不同,patch merger 划分特征空间是动态的——边界可变、数量可变,且每条肽离子都同时参与每个 patch,因此可以一次性关注多个区域。
随后进入标准的 Transformer 结构:token 加上一个分类用的 CLS token,经过 N 个编码器块(多头自注意力 + 两层感知机 + 归一化),最后由单层感知机读出 [0,1] 之间的二分类得分。注意一个细节:这里刻意不做位置编码——因为肽离子之间没有天然的"顺序"关系,模型可以自由学习与输入次序无关的类别相关关系。
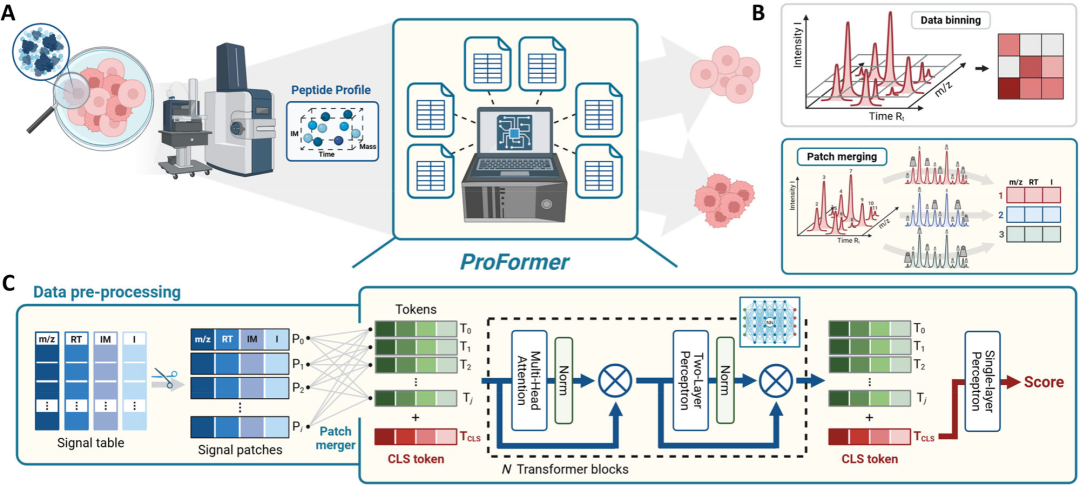
▲ 图1|ProFormer 的概念设计与流水线。a,深度学习辅助分类的整体构思:蛋白质组样本由四条特征定义的肽离子来表征,这些数据表可用来判别两类样本的轮廓。b,两种降维方式对比——上方为按固定网格结构的"数据分箱",把邻近信号压成图像样热图;下方为本文采用的"patch merging",用可学习的 patch merger 把肽信号加权累加成补丁(可处理任意维度特征),生成 Transformer 的输入 token。c,ProFormer 流水线:高维肽离子张量经 patch merger 压缩为 j 个 token,加上 CLS token 后送入 N 个编码器块(虚线框),每块含多头注意力、两层感知机与穿插的归一化层;CLS token 最终经单层感知机读出 [0,1] 区间的预测得分。j 与 N 均为可学习超参数。图 1A–C 由 Krull, KK 在 BioRender 创建。
三、14 种架构大比武:ProFormer 凭什么胜出
有了清晰的架构,接下来是最硬核的一步——同场竞技。
研究团队用一个精心设计的"困难任务"来做裁判:HeLa 细胞 ± 干扰素 γ(IFN-γ)。IFN-γ 是广为人知的免疫调节细胞因子,但对非免疫原性细胞只有温和效应。他们培养 6 份 HeLa 细胞,其中 3 份用 IFN-γ 处理 24 小时,在 timsTOF Pro 上以 diaPASEF 模式采集:
- 训练集:142 次进样,平均每针鉴定约 145,000 条肽离子; - 测试集:71 次进样,刻意在 6 个月后重新采集(仪器与参数不变),人为制造"时间维度的批次效应",考察模型能否把学到的关系从一个批次迁移到另一个批次。
数据质量很扎实:近一半肽离子在每个样本中都被检出,两套数据的中位缺失率仅 5–6%;训练集与测试集之间肽离子倍性变化的 Pearson 相关达 +0.784,并清晰捕捉到 IFN-γ 响应蛋白(如 WARS1)的上调。
然后见证差距:研究者把肽离子"身份"全部遮蔽(模拟无靶向的信号提取),只用 iRT、iIM、m/z、强度这些特征做判别,在同一测试集上横向比较(测试集 AUC):